お知らせ
【実装編】RAGの構築方法を具体的なコードで解説|PostgreSQL+pgvector×Claudeで作る社内ナレッジ検索
こんにちは、株式会社ZeroPlus CTOの矢島です。
最近、受託開発のご相談で「社内のマニュアルや規程をAIに答えさせたい」「問い合わせ対応をAIで自動化したい」というお話を本当によくいただきます。その中核になる技術が RAG(Retrieval-Augmented Generation:検索拡張生成) です。
RAGの概念を説明した記事は多いのですが、「実際にどう作るのか」まで踏み込んだ情報は意外と少ない印象です。そこで本記事では、弊社が業務アプリ制作で実際に採用している構成をベースに、動くコードでRAGの構築方法を解説します。
目次
この記事でわかること
- RAGの全体アーキテクチャと、各コンポーネントの役割
- ドキュメントの読み込み・チャンク分割・埋め込み(Embedding)の実装
- PostgreSQL+pgvectorでのベクトル検索の実装
- 日本語で精度を出すための「ハイブリッド検索」の実装
- Claudeを使った「根拠付き回答」の生成
- 本番運用前にやるべき精度評価の方法
対象読者
- PythonとSQLの基本がわかるエンジニア
- 社内向けAIチャットボットやナレッジ検索の導入を検討している方
- PoCで作ったRAGの精度に悩んでいる方
1. RAGとは? ― 30秒でおさらい
LLM(大規模言語モデル)は学習データにない情報、たとえば 自社の社内規程や製品マニュアル については答えられません。また、知らないことをもっともらしく答えてしまう「ハルシネーション」も課題です。
RAGはこれを、「質問に関連する文書を検索し、その内容をLLMに渡して回答させる」 という仕組みで解決します。
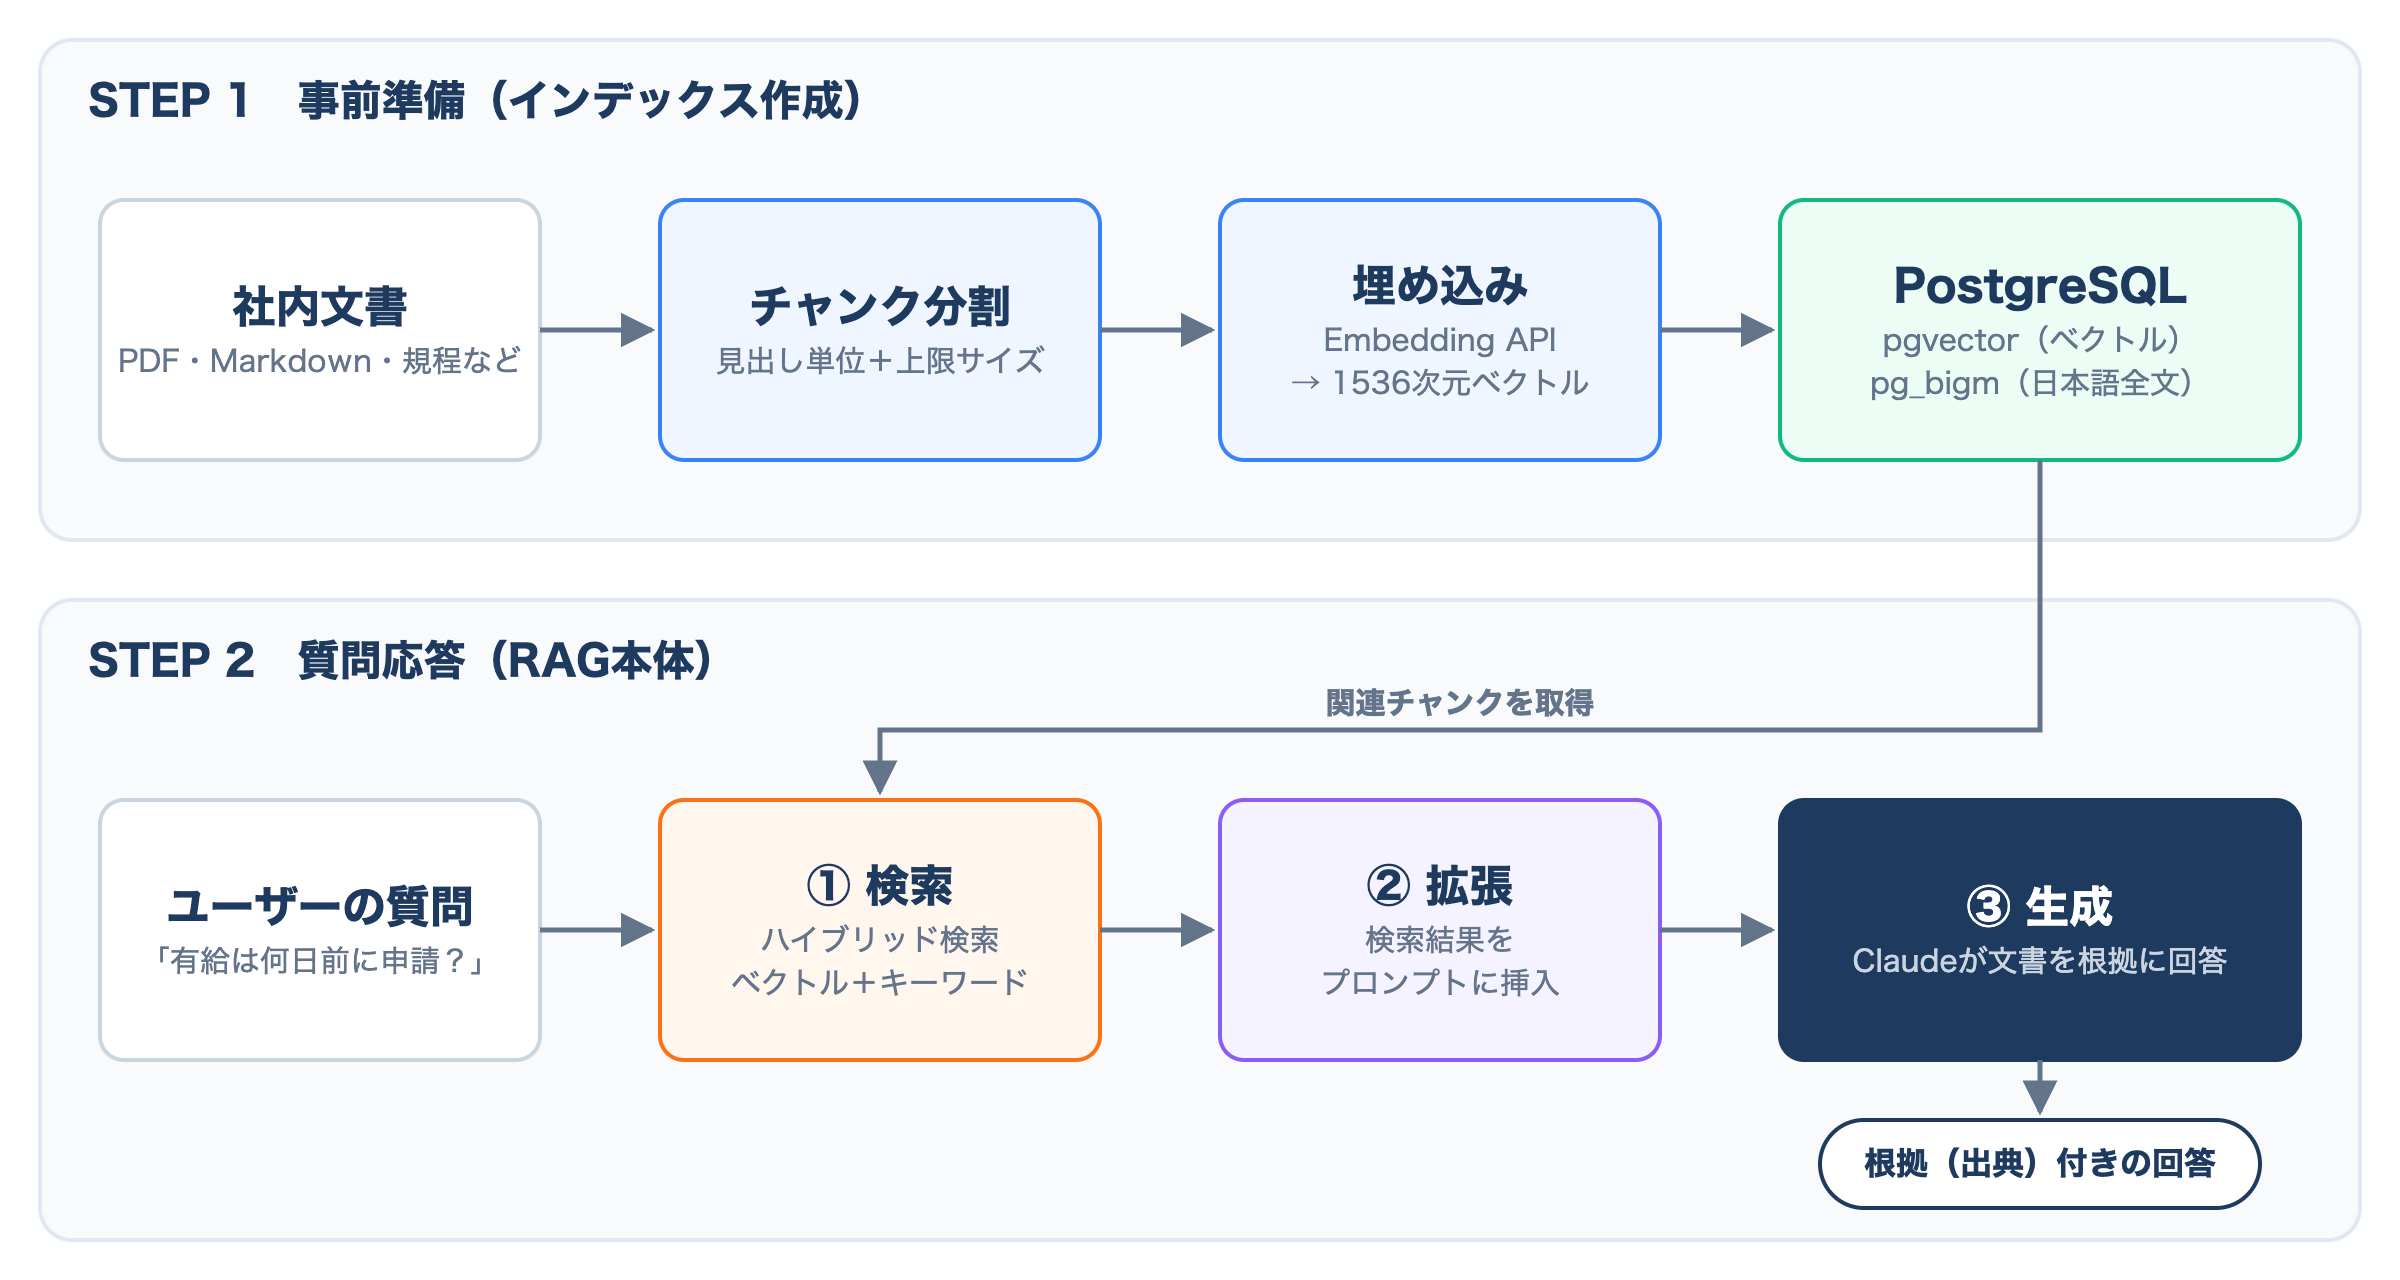
ファインチューニングと比べて、文書を差し替えるだけで最新情報に追従できる、回答の根拠(出典)を示せる のが大きなメリットです。
2. 今回の構成
| 役割 | 採用技術 | 選定理由 |
|---|---|---|
| 言語 | Python 3.11+ | AI系ライブラリが豊富 |
| ベクトルDB | PostgreSQL 16 + pgvector | 既存のRDBにそのまま載せられ、運用・バックアップが楽 |
| 日本語全文検索 | pg_bigm | 形態素解析なしで日本語の部分一致検索ができる |
| 埋め込みモデル | OpenAI text-embedding-3-small | 日本語の品質とコストのバランスが良い |
| 回答生成LLM | Claude(Anthropic API) | 長い文脈の読解と、指示への忠実さに優れる |
専用のベクトルDB(Pinecone、Qdrantなど)も選択肢ですが、業務システムではユーザー・権限データと同じDBで管理できるPostgreSQLが扱いやすい、というのが弊社の結論です。後述する「権限によるフィルタリング」もSQLのWHERE句で書けます。
ディレクトリ構成
rag-sample/
├── docker-compose.yml
├── schema.sql
├── requirements.txt
├── .env
├── config.py
├── ingest.py      # 文書の取り込み(チャンク分割・埋め込み・保存)
├── search.py      # ハイブリッド検索
├── answer.py      # 回答生成
└── evaluate.py    # 精度評価
3. 環境構築
3-1. PostgreSQL(pgvector + pg_bigm)を起動
pgvector公式イメージにpg_bigmを追加したDockerfileを用意します。
# Dockerfile.db
FROM pgvector/pgvector:pg16

RUN apt-get update && apt-get install -y build-essential postgresql-server-dev-16 wget \
 && wget -qO- https://github.com/pgbigm/pg_bigm/archive/refs/tags/v1.2-20240606.tar.gz | tar xz \
 && cd pg_bigm-1.2-20240606 && make USE_PGXS=1 && make USE_PGXS=1 install \
 && cd .. && rm -rf pg_bigm-* \
 && apt-get purge -y build-essential wget && apt-get autoremove -y
# docker-compose.yml
services:
db:
build:
context: .
dockerfile: Dockerfile.db
environment:
POSTGRES_USER: rag
POSTGRES_PASSWORD: rag
POSTGRES_DB: rag
ports:
- "5432:5432"
volumes:
- ./schema.sql:/docker-entrypoint-initdb.d/schema.sql※ pg_bigmのバージョンは執筆時点のものです。最新版は公式リポジトリをご確認ください。
3-2. テーブル定義
-- schema.sql
CREATE EXTENSION IF NOT EXISTS vector;
CREATE EXTENSION IF NOT EXISTS pg_bigm;

CREATE TABLE documents (
    id          BIGSERIAL PRIMARY KEY,
    source      TEXT NOT NULL UNIQUE,      -- ファイルパスやURL
    title       TEXT,
    checksum    TEXT NOT NULL,             -- 差分更新用
    updated_at  TIMESTAMPTZ DEFAULT now()
);

CREATE TABLE chunks (
    id           BIGSERIAL PRIMARY KEY,
    document_id  BIGINT REFERENCES documents(id) ON DELETE CASCADE,
    chunk_index  INT NOT NULL,
    heading      TEXT,                     -- チャンクが属する見出し
    content      TEXT NOT NULL,
    metadata     JSONB DEFAULT '{}',       -- 部署・公開範囲など
    embedding    vector(1536) NOT NULL
);

-- ベクトル検索用(HNSWインデックス、コサイン距離)
CREATE INDEX chunks_embedding_idx
    ON chunks USING hnsw (embedding vector_cosine_ops);

-- 日本語キーワード検索用(2-gram)
CREATE INDEX chunks_content_bigm_idx
    ON chunks USING gin (content gin_bigm_ops);

-- メタデータでの絞り込み用
CREATE INDEX chunks_metadata_idx ON chunks USING gin (metadata);
checksum を持たせているのは、変更のあった文書だけ再埋め込みするためです。埋め込みAPIのコストと処理時間を大きく削減できます。
3-3. Pythonライブラリ
# requirements.txt
anthropic
openai
psycopg[binary]
pgvector
numpy
pypdf
python-dotenv
tiktoken
# .env
DATABASE_URL=postgresql://rag:rag@localhost:5432/rag
OPENAI_API_KEY=sk-...
ANTHROPIC_API_KEY=sk-ant-...
CLAUDE_MODEL=claude-sonnet-4-5 # 利用するモデル名に合わせて変更# config.py
import os
import psycopg
from dotenv import load_dotenv
from pgvector.psycopg import register_vector
load_dotenv()
EMBED_MODEL = "text-embedding-3-small"
EMBED_DIM = 1536
CLAUDE_MODEL = os.environ["CLAUDE_MODEL"]
def get_conn() -> psycopg.Connection:
conn = psycopg.connect(os.environ["DATABASE_URL"])
register_vector(conn)
return conn4. 文書の取り込み(Ingestion)
RAGの精度の 7割は取り込み工程で決まる と言っても過言ではありません。特に重要なのが チャンク分割 です。
4-1. チャンク分割の考え方
| 分割方法 | メリット | デメリット |
|---|---|---|
| 固定文字数で分割 | 実装が簡単 | 文の途中で切れ、意味が壊れる |
| 段落・見出し単位で分割 | 意味のまとまりを保てる | チャンクサイズがばらつく |
| 見出し単位+上限サイズで再分割(推奨) | 両者のいいとこ取り | 実装がやや複雑 |
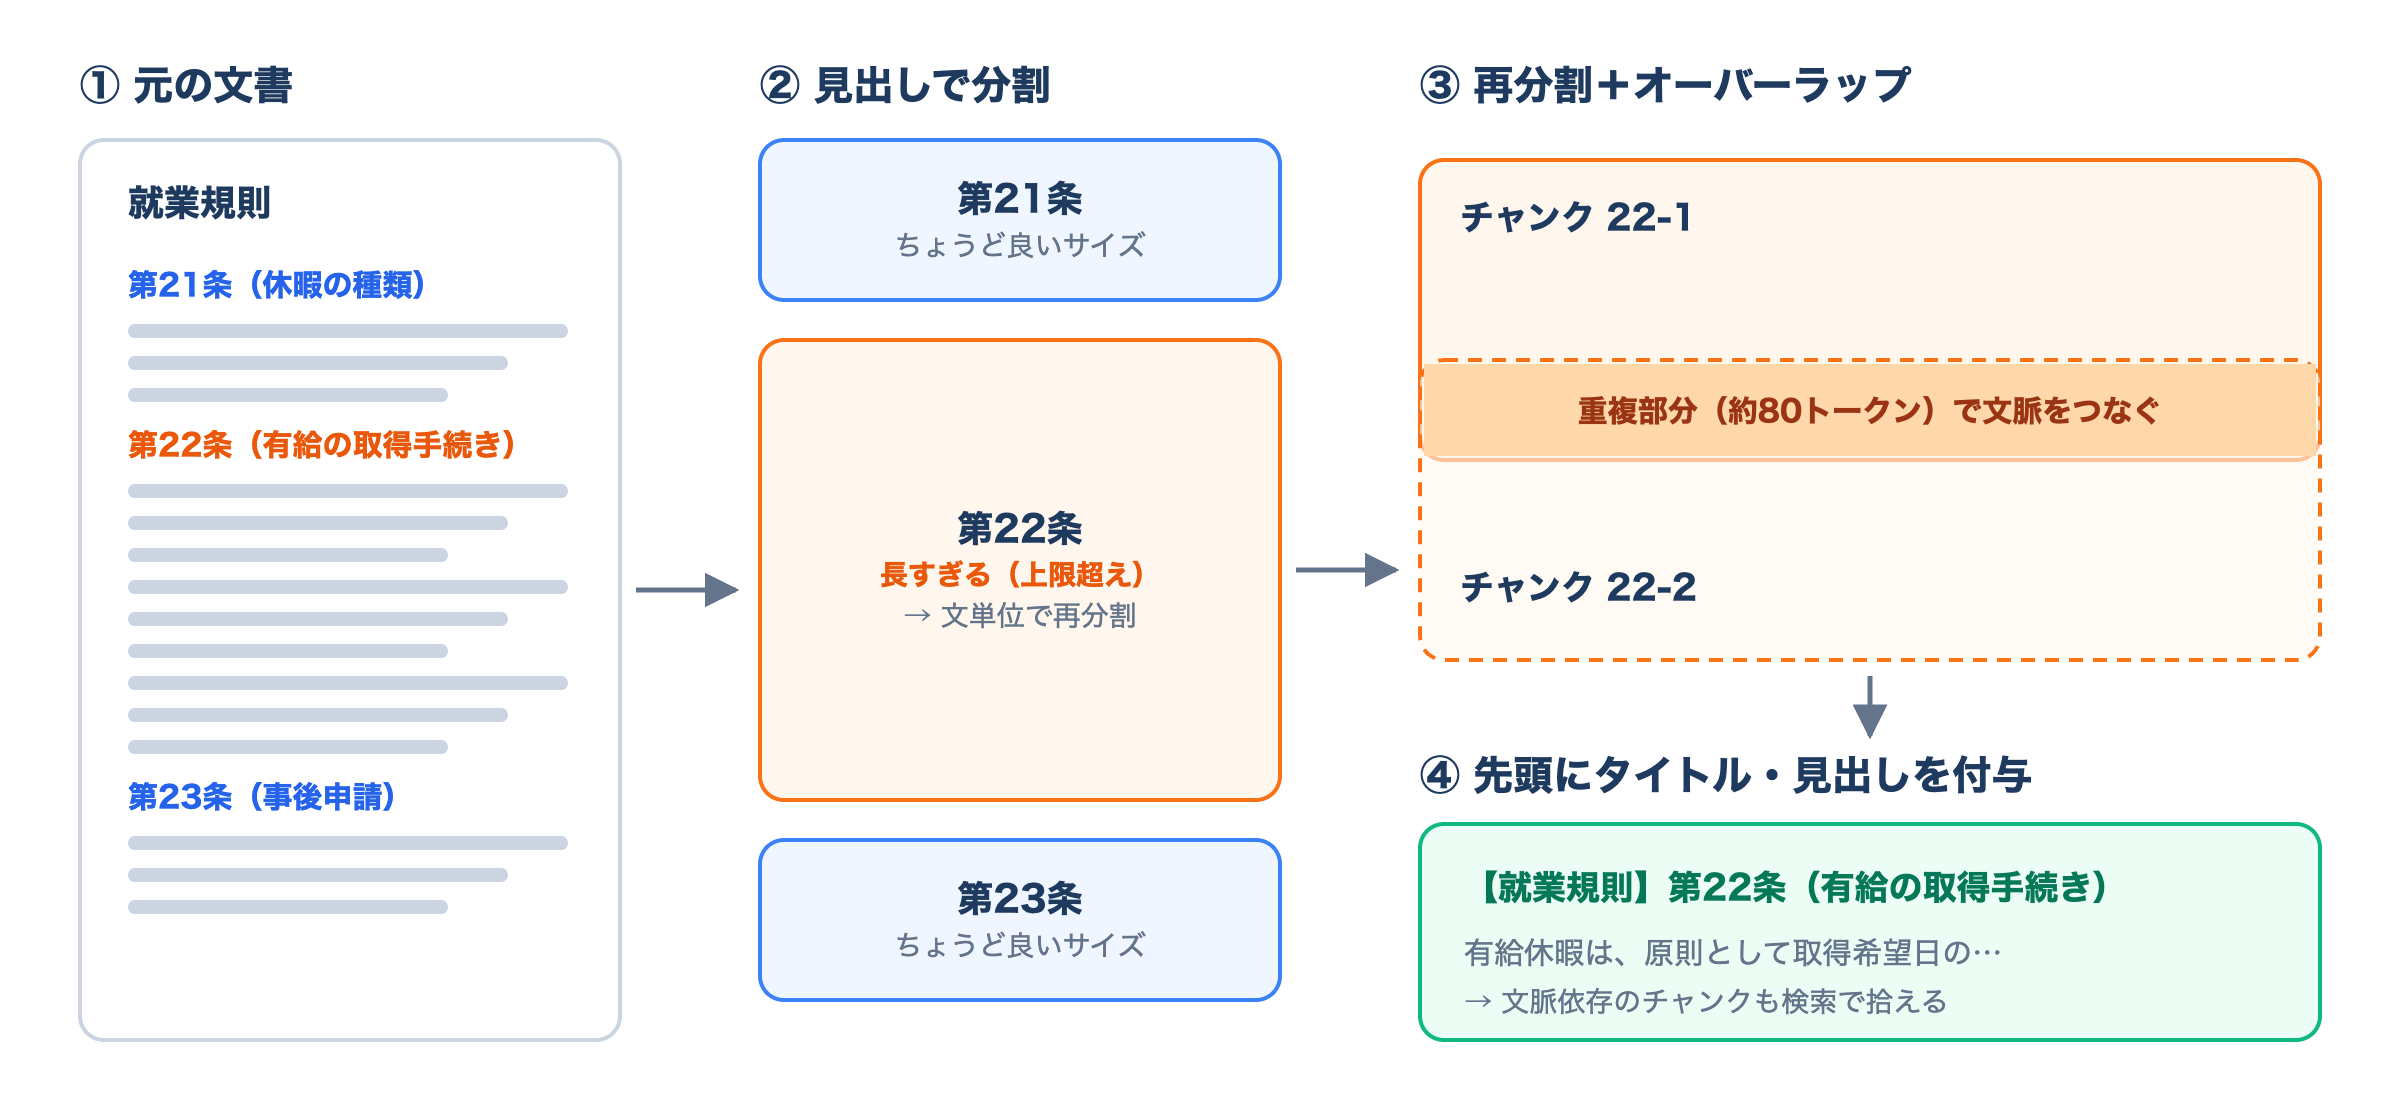
今回は 「見出しで大きく分け、長すぎるものだけ文単位で再分割、前後を少し重複(オーバーラップ)させる」 方式を実装します。また、各チャンクの先頭に 文書タイトルと見出しを付与 します。これにより「第3条」のような文脈依存のチャンクでも、何の文書の何の話かが検索で拾えるようになります。
# ingest.py
import hashlib
import re
import sys
from pathlib import Path

import numpy as np
import tiktoken
from openai import OpenAI
from psycopg.types.json import Jsonb
from pypdf import PdfReader

from config import EMBED_MODEL, get_conn

openai_client = OpenAI()
enc = tiktoken.get_encoding("cl100k_base")

MAX_TOKENS = 500      # 1チャンクの上限トークン数
OVERLAP_TOKENS = 80   # 前後チャンクとの重複

def count_tokens(text: str) -> int:
    return len(enc.encode(text))

# ---------- 1. 読み込み ----------
def load_text(path: Path) -> str:
    if path.suffix.lower() == ".pdf":
        reader = PdfReader(path)
        return "\n".join(page.extract_text() or "" for page in reader.pages)
    return path.read_text(encoding="utf-8")

# ---------- 2. 見出しで分割 ----------
HEADING_RE = re.compile(r"^(#{1,4}\s+.+|第[0-90-9一二三四五六七八九十百]+[章条節].*)$", re.M)

def split_by_heading(text: str) -> list[tuple[str, str]]:
    """(見出し, 本文) のリストを返す。Markdown見出しと「第◯条」形式に対応"""
    sections, last_pos, last_heading = [], 0, ""
    for m in HEADING_RE.finditer(text):
        body = text[last_pos:m.start()].strip()
        if body:
            sections.append((last_heading, body))
        last_heading = m.group(0).lstrip("# ").strip()
        last_pos = m.end()
    tail = text[last_pos:].strip()
    if tail:
        sections.append((last_heading, tail))
    return sections

# ---------- 3. 長いセクションを文単位で再分割 ----------
SENTENCE_RE = re.compile(r"(?<=[。!?!?\n])")

def split_long(body: str) -> list[str]:
    if count_tokens(body) <= MAX_TOKENS:
        return [body]
    sentences = [s for s in SENTENCE_RE.split(body) if s.strip()]
    chunks, current = [], []
    for sent in sentences:
        if current and count_tokens("".join(current) + sent) > MAX_TOKENS:
            chunks.append("".join(current))
            # オーバーラップ:末尾の文を次のチャンクに引き継ぐ
            overlap = []
            while current and count_tokens("".join(overlap)) < OVERLAP_TOKENS:
                overlap.insert(0, current.pop())
            current = overlap
        current.append(sent)
    if current:
        chunks.append("".join(current))
    return chunks

def make_chunks(title: str, text: str) -> list[dict]:
    results = []
    for heading, body in split_by_heading(text):
        for piece in split_long(body):
            # 検索精度向上のため、タイトルと見出しを先頭に付与
            content = f"【{title}】{heading}\n{piece}".strip()
            results.append({"heading": heading, "content": content})
    return results

# ---------- 4. 埋め込み(バッチ処理) ----------
def embed(texts: list[str], batch_size: int = 100) -> list[np.ndarray]:
    vectors = []
    for i in range(0, len(texts), batch_size):
        res = openai_client.embeddings.create(model=EMBED_MODEL, input=texts[i:i + batch_size])
        vectors.extend(np.array(d.embedding, dtype=np.float32) for d in res.data)
    return vectors

# ---------- 5. 保存(差分更新) ----------
def ingest_file(conn, path: Path, metadata: dict | None = None):
    text = load_text(path)
    checksum = hashlib.sha256(text.encode()).hexdigest()
    source, title = str(path), path.stem

    row = conn.execute("SELECT id, checksum FROM documents WHERE source = %s", (source,)).fetchone()
    if row and row[1] == checksum:
        print(f"skip (unchanged): {source}")
        return

    chunks = make_chunks(title, text)
    vectors = embed([c["content"] for c in chunks])

    with conn.transaction():
        if row:  # 更新時は古いチャンクを削除(CASCADE)
            conn.execute("DELETE FROM documents WHERE id = %s", (row[0],))
        doc_id = conn.execute(
            "INSERT INTO documents (source, title, checksum) VALUES (%s, %s, %s) RETURNING id",
            (source, title, checksum),
        ).fetchone()[0]
        with conn.cursor() as cur:
            cur.executemany(
                """INSERT INTO chunks (document_id, chunk_index, heading, content, metadata, embedding)
                   VALUES (%s, %s, %s, %s, %s, %s)""",
                [
                    (doc_id, i, c["heading"], c["content"],
                     Jsonb(metadata or {}), v)
                    for i, (c, v) in enumerate(zip(chunks, vectors))
                ],
            )
    print(f"ingested: {source} ({len(chunks)} chunks)")

if __name__ == "__main__":
    target = Path(sys.argv[1])
    files = [p for p in target.rglob("*") if p.suffix.lower() in {".md", ".txt", ".pdf"}]
    with get_conn() as conn:
        for f in files:
            ingest_file(conn, f, metadata={"visibility": "all"})
実行例:
docker compose up -d
pip install -r requirements.txt
python ingest.py ./docs
💡 実務Tips:PDFの品質に注意
スキャンPDFや表の多いPDFは、pypdfではテキストが崩れることがよくあります。取り込み後に必ずチャンクの中身を目視確認しましょう。崩れる場合はOCRや、PDFを解析するドキュメントパーサーの導入を検討します。「ゴミを入れればゴミが出る」はRAGでも同じです。
5. 検索(Retrieval)― ハイブリッド検索で日本語の精度を上げる
5-1. ベクトル検索だけでは足りない理由
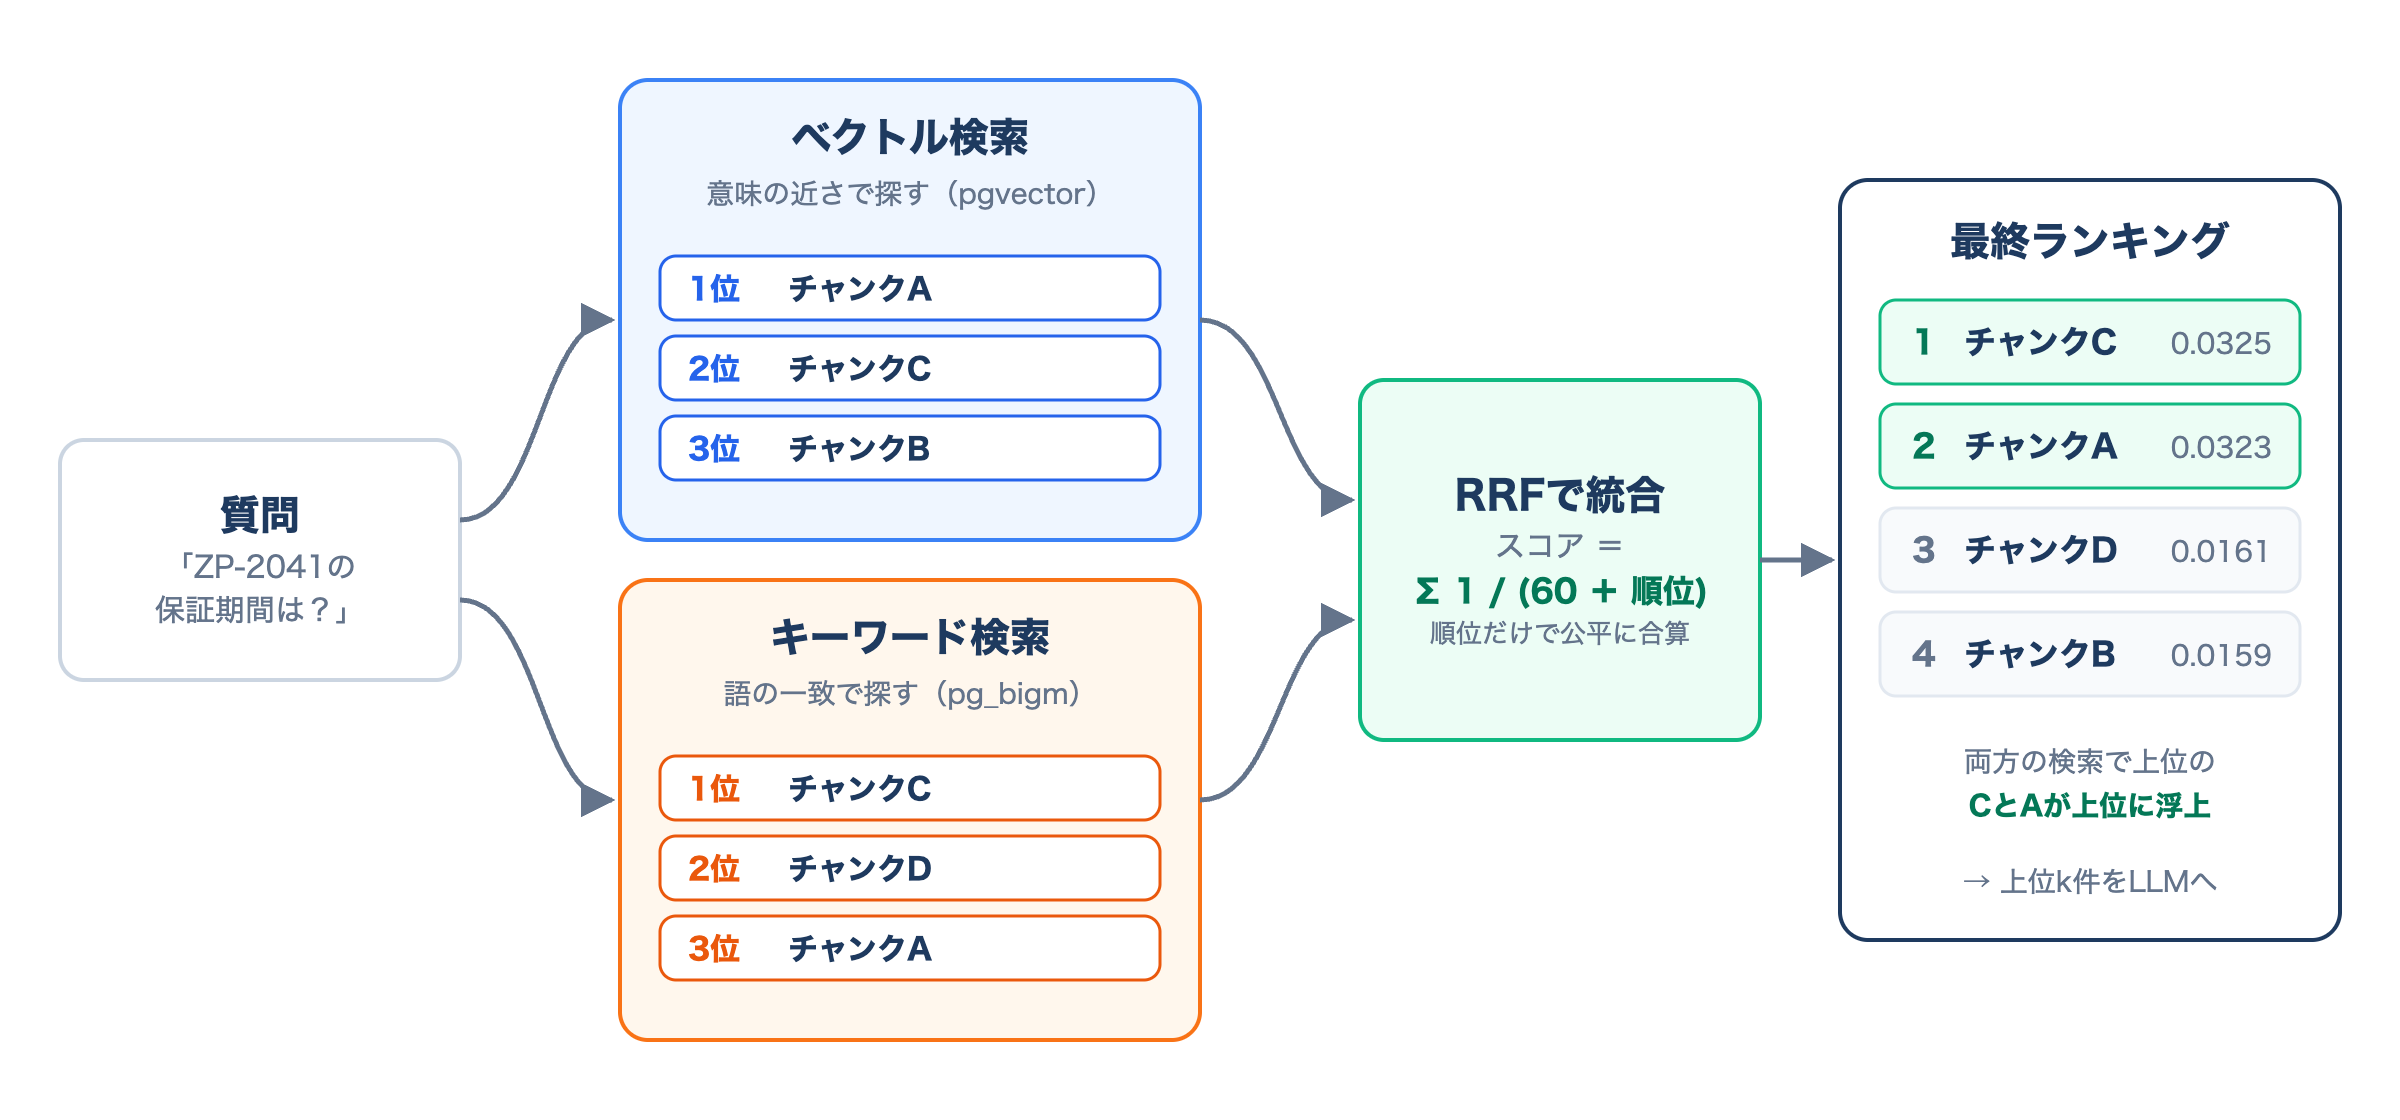
ベクトル検索は「意味の近さ」で探すのが得意で、「有給の申請方法」で「年次休暇取得の手続き」を見つけられます。一方で、型番・社内用語・固有名詞の完全一致には弱い という弱点があります(例:「ZP-2041の保証期間」)。
そこで、ベクトル検索とキーワード検索を併用し、結果を統合する「ハイブリッド検索」 を実装します。統合には、実装がシンプルで効果の高い RRF(Reciprocal Rank Fusion) を使います。
RRFスコア = Σ 1 / (k + 各検索での順位) ※ k は通常 60スコアの尺度が異なる2つの検索結果を、順位だけで公平に統合できるのがRRFの利点です。
# search.py
from dataclasses import dataclass

import numpy as np
from openai import OpenAI

from config import EMBED_MODEL, get_conn

openai_client = OpenAI()

@dataclass
class Hit:
    id: int
    source: str
    heading: str
    content: str
    score: float

def embed_query(q: str) -> np.ndarray:
    res = openai_client.embeddings.create(model=EMBED_MODEL, input=[q])
    return np.array(res.data[0].embedding, dtype=np.float32)

def vector_search(conn, qvec, k: int, visibility: list[str]) -> list[int]:
    rows = conn.execute(
        """SELECT id FROM chunks
           WHERE metadata->>'visibility' = ANY(%s)
           ORDER BY embedding <=> %s
           LIMIT %s""",
        (visibility, qvec, k),
    ).fetchall()
    return [r[0] for r in rows]

def keyword_search(conn, query: str, k: int, visibility: list[str]) -> list[int]:
    # スペース区切りの各語について部分一致(pg_bigmのlikequeryでインデックスが効く)
    terms = [t for t in query.split() if len(t) >= 2] or [query]
    where = " OR ".join(["content LIKE likequery(%s)"] * len(terms))
    rows = conn.execute(
        f"""SELECT id FROM chunks
            WHERE ({where}) AND metadata->>'visibility' = ANY(%s)
            ORDER BY bigm_similarity(content, %s) DESC
            LIMIT %s""",
        (*terms, visibility, query, k),
    ).fetchall()
    return [r[0] for r in rows]

def rrf(rank_lists: list[list[int]], k: int = 60) -> dict[int, float]:
    scores: dict[int, float] = {}
    for ranks in rank_lists:
        for rank, cid in enumerate(ranks, start=1):
            scores[cid] = scores.get(cid, 0.0) + 1.0 / (k + rank)
    return scores

def hybrid_search(query: str, top_k: int = 5, candidates: int = 30,
                  visibility: list[str] | None = None) -> list[Hit]:
    visibility = visibility or ["all"]
    with get_conn() as conn:
        qvec = embed_query(query)
        vec_ids = vector_search(conn, qvec, candidates, visibility)
        kw_ids = keyword_search(conn, query, candidates, visibility)

        fused = sorted(rrf([vec_ids, kw_ids]).items(), key=lambda x: x[1], reverse=True)[:top_k]
        if not fused:
            return []
        ids = [cid for cid, _ in fused]
        rows = conn.execute(
            """SELECT c.id, d.source, c.heading, c.content
               FROM chunks c JOIN documents d ON d.id = c.document_id
               WHERE c.id = ANY(%s)""",
            (ids,),
        ).fetchall()
    by_id = {r[0]: r for r in rows}
    return [Hit(cid, by_id[cid][1], by_id[cid][2], by_id[cid][3], score) for cid, score in fused]

if __name__ == "__main__":
    import sys
    for h in hybrid_search(sys.argv[1]):
        print(f"[{h.score:.4f}] {h.source} / {h.heading}\n  {h.content[:80]}...\n")
visibility の部分が、権限によるフィルタリング です。たとえば「役員向け文書は役員にしか検索させない」といった制御を、検索時点でSQLで確実にかけられます。LLMに「この文書は見せないで」と指示するのは安全ではないので、権限制御は必ず検索層で行いましょう。
5-2. さらに精度を上げる:リランキング
候補を多めに取得したあと、リランカー(Cross-Encoder型のモデルやリランクAPI)で並べ替える と、上位の精度がさらに向上します。今回は割愛しますが、hybrid_search で30件取得 → リランカーで上位5件に絞る、という形で簡単に差し込めます。
6. 回答生成(Generation)
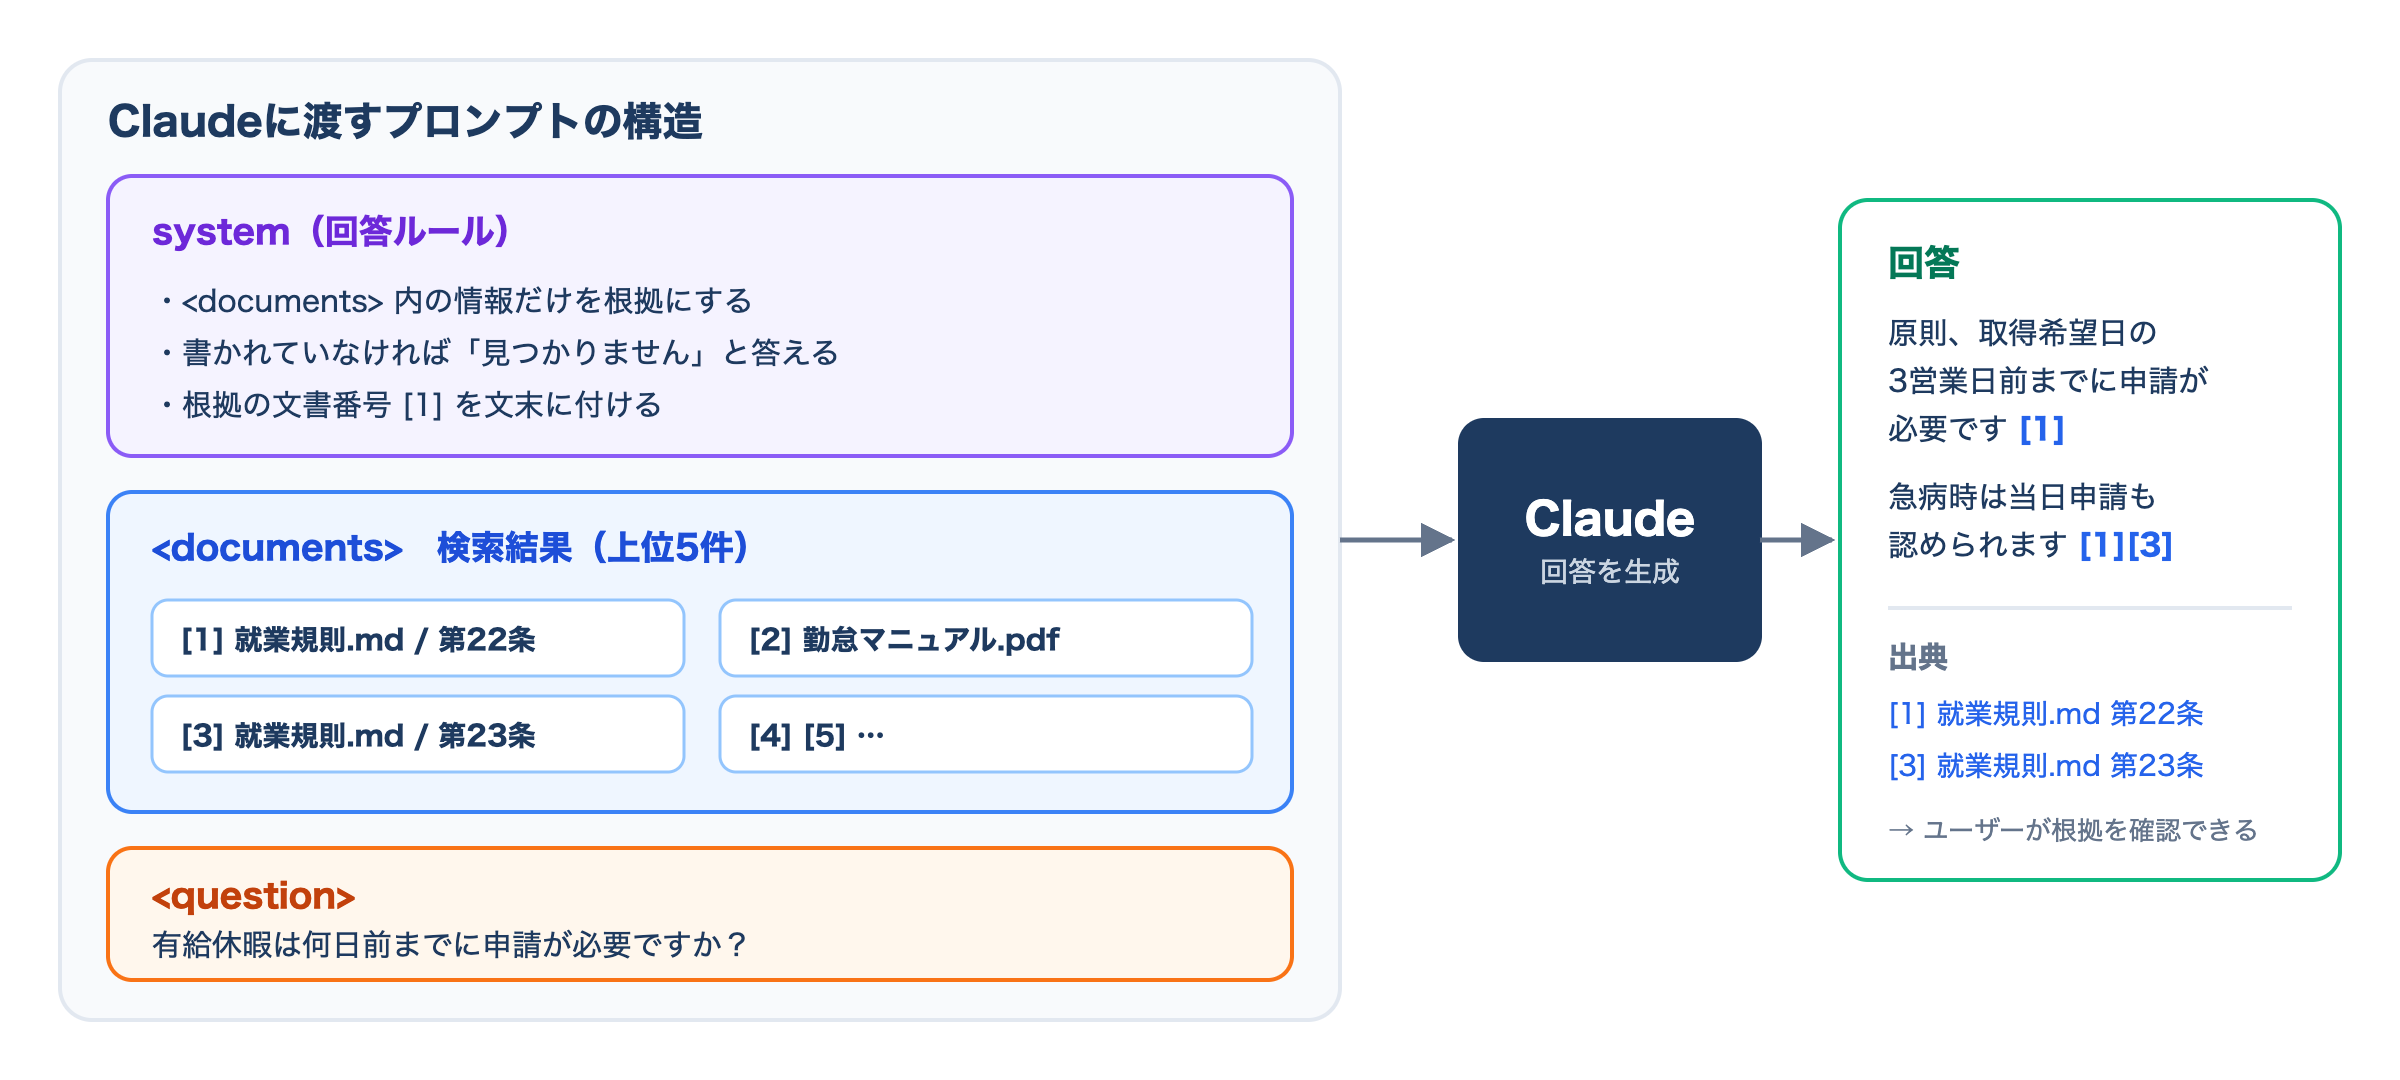
検索したチャンクをClaudeに渡して回答を生成します。ポイントは次の3つです。
- 文書に書かれていないことは「わからない」と答えさせる(ハルシネーション対策)
- 回答に出典番号を付けさせる(ユーザーが根拠を確認できる)
- 文書をXMLタグで明確に区切る(指示と資料を混同させない)
# answer.py
import sys

import anthropic

from config import CLAUDE_MODEL
from search import Hit, hybrid_search

client = anthropic.Anthropic()

SYSTEM_PROMPT = """あなたは社内ナレッジに基づいて質問に答えるアシスタントです。
以下のルールを厳守してください。

- <documents> 内の情報のみを根拠に回答すること。
- 文書に答えが書かれていない場合は、推測せず「社内資料の中に該当する情報が見つかりませんでした」と答えること。
- 根拠にした文書の番号を、該当する文の末尾に [1] のように付けること。
- 簡潔に、箇条書きを適宜使って回答すること。"""

def build_context(hits: list[Hit]) -> str:
    docs = []
    for i, h in enumerate(hits, start=1):
        docs.append(
            f'<document index="{i}">\n'
            f"<source>{h.source}</source>\n"
            f"<content>\n{h.content}\n</content>\n"
            f"</document>"
        )
    return "<documents>\n" + "\n".join(docs) + "\n</documents>"

def answer(question: str) -> dict:
    hits = hybrid_search(question, top_k=5)
    if not hits:
        return {"answer": "社内資料の中に該当する情報が見つかりませんでした。", "sources": []}

    response = client.messages.create(
        model=CLAUDE_MODEL,
        max_tokens=1024,
        system=SYSTEM_PROMPT,
        messages=[{
            "role": "user",
            "content": f"{build_context(hits)}\n\n<question>{question}</question>",
        }],
    )
    text = "".join(block.text for block in response.content if block.type == "text")
    sources = [{"index": i, "source": h.source, "heading": h.heading}
               for i, h in enumerate(hits, start=1)]
    return {"answer": text, "sources": sources}

if __name__ == "__main__":
    result = answer(sys.argv[1])
    print(result["answer"])
    print("\n--- 出典 ---")
    for s in result["sources"]:
        print(f"[{s['index']}] {s['source']} / {s['heading']}")
実行例:
$ python answer.py "有給休暇は何日前までに申請が必要ですか?"
有給休暇は、原則として取得希望日の3営業日前までに申請が必要です [1]。
ただし、急病などやむを得ない場合は当日の申請も認められます [1][3]。

--- 出典 ---
[1] docs/就業規則.md / 第22条(年次有給休暇の取得手続き)
[2] docs/勤怠システムマニュアル.pdf / 休暇申請の方法
[3] docs/就業規則.md / 第23条(事後申請)ここまでで、「取り込み → ハイブリッド検索 → 根拠付き回答」というRAGの基本形が完成です。FastAPIなどでAPI化すれば、Slackボットや社内Webアプリ、業務アプリからそのまま呼び出せます。
7. 精度評価 ― 「なんとなく良さそう」で終わらせない
RAGはPoCでは良く見えても、本番で「肝心な質問に答えられない」ことがよくあります。改善のためには、まず数値で測ることが欠かせません。
7-1. 評価データを作る
実際に想定される質問と、その答えが載っている文書(正解ソース)のペアを30〜100件ほど用意します。現場の担当者に「よく聞かれる質問」を出してもらうのが一番確実です。
{"question": "有給休暇は何日前までに申請が必要?", "expected_source": "docs/就業規則.md"}
{"question": "ZP-2041の保証期間は?", "expected_source": "docs/製品保証規定.pdf"}
7-2. 検索精度(Recall@k)を測る
まず 「正解の文書が検索結果の上位k件に入っているか」 を測ります。検索で拾えていなければ、LLMがどれだけ賢くても正しく答えられないからです。
# evaluate.py
import json
import sys

from search import hybrid_search

def recall_at_k(path: str, k: int = 5) -> float:
    cases = [json.loads(line) for line in open(path, encoding="utf-8")]
    hit_count = 0
    for c in cases:
        sources = {h.source for h in hybrid_search(c["question"], top_k=k)}
        ok = c["expected_source"] in sources
        hit_count += ok
        if not ok:
            print(f"MISS: {c['question']}")
    score = hit_count / len(cases)
    print(f"Recall@{k}: {score:.1%} ({hit_count}/{len(cases)})")
    return score

if __name__ == "__main__":
recall_at_k(sys.argv[1])MISSになった質問を1つずつ見ていくと、「チャンクが細かすぎて文脈が切れている」「社内の略語で書かれていて検索に引っかからない」など、改善点が具体的に見えてきます。チャンクサイズやハイブリッド検索の有無を変えながら、この数値を比較していきましょう。
7-3. 回答品質を測る
回答については、別のLLMに「回答が文書の内容に忠実か」「質問に答えているか」を採点させる LLM-as-a-Judge の手法が実用的です。ただし採点結果は鵜呑みにせず、定期的に人がサンプリングして確認することをおすすめします。
8. 本番運用に向けたチェックリスト
PoCから本番へ進める際に、弊社がプロジェクトで必ず確認している項目です。
- ☐ 権限制御:ユーザーごとに閲覧可能な文書を検索層で絞り込めているか
- ☐ 文書の更新フロー:文書の追加・更新・削除がDBに自動反映されるか(差分更新・定期バッチ)
- ☐ ログ取得:質問・検索結果・回答を記録し、改善に使えるか(個人情報の扱いに注意)
- ☐ フィードバック導線:回答に「役に立った/立たなかった」ボタンがあるか
- ☐ コスト管理:1質問あたりのAPIコストを把握し、上限やキャッシュを設定しているか
- ☐ フォールバック:回答できない場合に、担当者への問い合わせ導線があるか
- ☐ プロンプトインジェクション対策:文書内の悪意ある指示にLLMが従わない設計になっているか
まとめ
本記事では、RAGの構築方法を実装コード付きで解説しました。
- 取り込み:見出し単位+上限サイズで分割し、タイトル・見出しを付与する
- 検索:日本語ではベクトル検索+キーワード検索のハイブリッドが効く。権限制御は検索層で
- 生成:「文書にないことは答えない」「出典を付ける」をプロンプトで徹底する
- 評価:Recall@kで検索精度を数値化し、MISSを1つずつ潰す
RAGは「作るだけ」なら数日で動きますが、業務で使える精度に仕上げるには、データ整備と評価・改善の地道なサイクルが欠かせません。
RAGを活用したAIアプリ制作のご相談はZeroPlusへ
株式会社ZeroPlusでは、RAGを活用した社内ナレッジ検索・問い合わせ対応チャットボットなど、生成AIを組み込んだ業務アプリ制作・システム開発を承っています。
- 「社内文書をAIで検索できるようにしたい」
- 「PoCで作ったRAGの精度が上がらない」
- 「既存の業務システムにAI機能を組み込みたい」
といったお悩みがあれば、要件整理の段階からお気軽にご相談ください。ラボ型(チーム提供)での継続的な開発支援にも対応しています。